













 Immagine di magnific

L’Autonomous Enterprise presentata da Sap al Sap Now AI Tour di Milano poggia su un’idea semplice: agenti che eseguono, persone che mantengono il governo delle decisioni. Perché il modello regga, le persone devono saper decidere, e non è una competenza che si ottiene per delega. Sap include nel lavoro con i clienti formazione, change management e misurazione dell’utilizzo. Il gruppo Oniverse, nella stessa giornata, ha raccontato di aver presentato internamente una decina di casi d’uso di AI il cui valore si misura anzitutto nel tempo risparmiato dai singoli. Utilizzo e tempo risparmiato sono metriche legittime e comode, ma dicono quanto si fa, non quanto si impara. Su questa differenza la ricerca recente ha qualcosa da dire.
Un assunto da verificare, tre variazioni sul tema
L’assunto implicito di molti progetti è che chi svolge meglio il compito con l’assistente stia anche imparando. La psicologia cognitiva lo mette in dubbio da tempo: secondo Soderstrom e Bjork (2015), facilitare l’esercizio migliora il risultato immediato ma non garantisce che qualcosa resti il giorno dopo. Un assistente che risponde bene a tutto è il rimedio più efficace contro la fatica. Peccato che la fatica, in parte, serva.
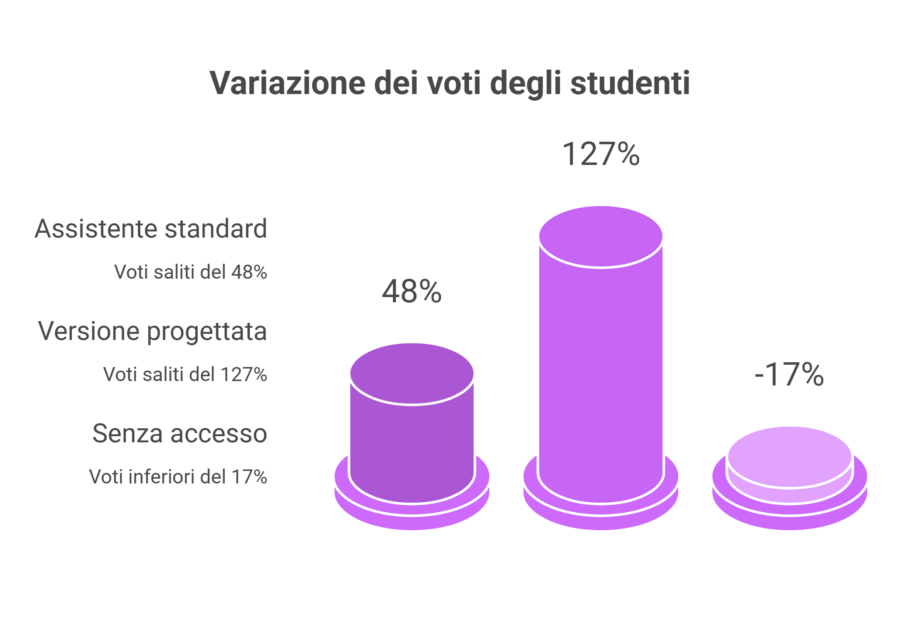
La prima variazione sul tema è la più netta. In uno studio pubblicato su Pnas nel 2025, quasi mille studenti di liceo hanno usato due tutor basati su Gpt-4. Durante l’esercizio i voti sono saliti del 48% con l’assistente standard e del 127% con una versione progettata per proteggere l’apprendimento. Tolto l’accesso, chi aveva usato la versione standard è andato peggio di chi non l’aveva mai avuta, con voti inferiori del 17%. La versione con vincoli, che dava indizi e non soluzioni, ha in gran parte evitato il danno. Limite: una sola scuola, solo matematica.
La seconda variazione arriva dal mondo tech. In un esperimento randomizzato diffuso nel 2026 come preprint da ricercatori di Anthropic, l’azienda che sviluppa Claude, 52 programmatori, in maggioranza con oltre sette anni di esperienza, dovevano imparare una libreria Python mai usata prima, con o senza assistente. La velocità non è migliorata in modo significativo, ma al test successivo il gruppo con l’AI ha ottenuto un punteggio inferiore del 17%, circa due voti, con il divario maggiore sul debug, cioè sulla capacità di capire quando il codice sbaglia e perché. Non tutti, però, sono andati male: i punteggi più alti sono andati a chi faceva domande concettuali o chiedeva spiegazioni, anche dopo essersi fatto scrivere il codice; i più bassi a chi delegava all’AI la scrittura o la correzione.
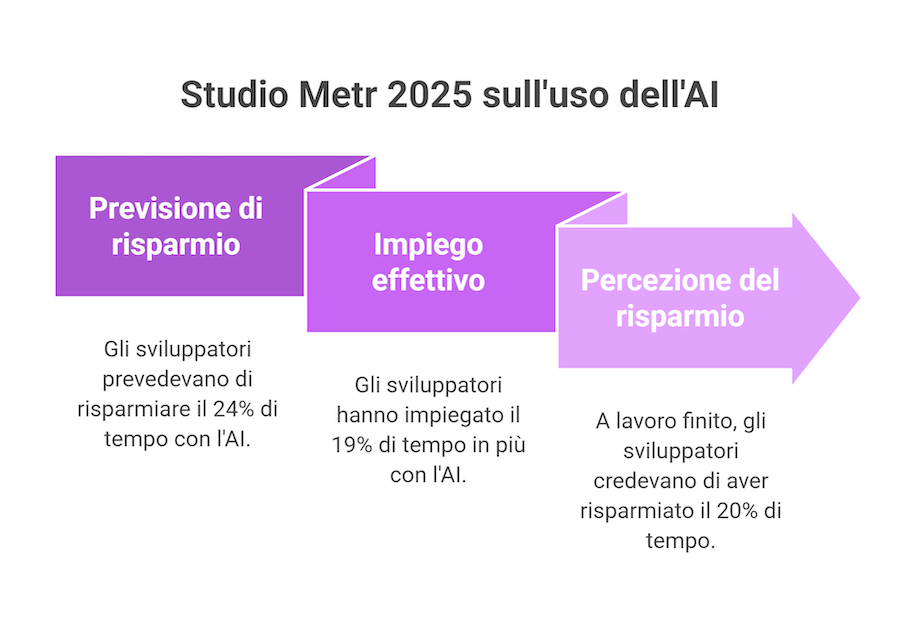
La terza variazione sul tema riguarda la percezione. Nello studio Metr del 2025, 16 sviluppatori esperti, impegnati su 246 compiti nei propri progetti open source, hanno impiegato il 19% di tempo in più con l’AI. Prevedevano di risparmiarne il 24% e, a lavoro finito, credevano di averne risparmiato il 20%. Erano convinti di correre. I cronometri dicevano altro. Il campione è piccolo e gli strumenti sono dell’inizio 2025. Su un piano vicino, un’indagine di Microsoft Research e Carnegie Mellon su 319 lavoratori della conoscenza associa più fiducia nell’AI a meno pensiero critico dichiarato. Sono dati auto-riferiti.
La relazione non si delega (per ora)
Il coaching pone la domanda in modo diverso: cosa serve perché lo sviluppo avvenga. In uno studio randomizzato del 2026, 114 manager e dirigenti sono stati assegnati a quattro settimane di coaching con un coach accreditato, a un chatbot su WhatsApp o a una lista d’attesa. Il coaching umano ha migliorato obiettivi, autoefficacia e stress percepito. Il chatbot, su quasi tutte le misure, non si è distinto da chi era in lista d’attesa, cioè da chi non aveva ancora ricevuto alcun coaching. Le sessioni con il chatbot sono state molto più brevi dell’ora prevista e l’abbandono è stato circa dieci volte più alto. Uno degli autori sviluppa il chatbot e dichiara un interesse commerciale. La versione testata risale al 2024, e uno studio precedente, su studenti e obiettivi definiti, aveva trovato risultati più favorevoli: un quadro da seguire, non un verdetto.
Tre domande per chi guida un progetto di AI
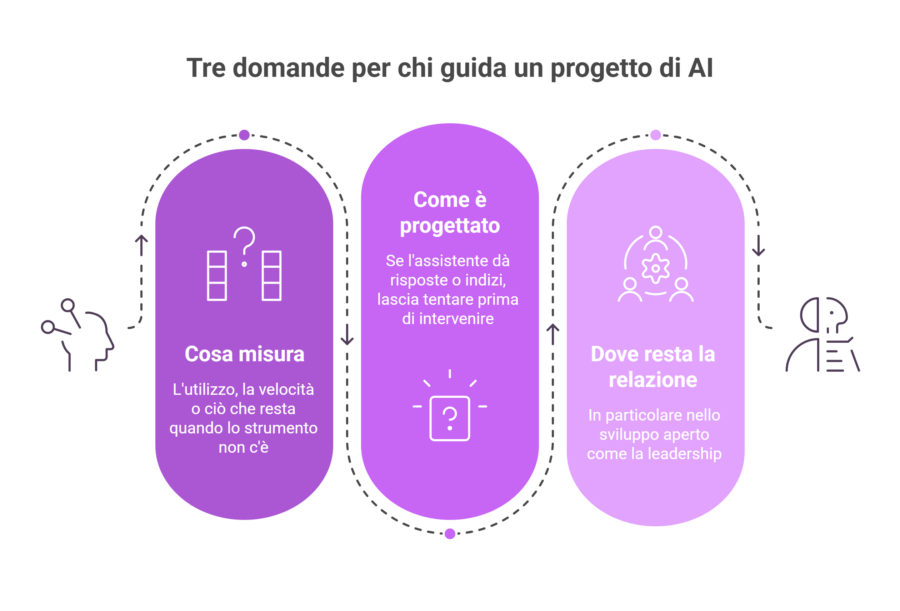
La prima: cosa misura il progetto, l’utilizzo, la velocità o ciò che resta quando lo strumento non c’è? La seconda: come è progettato l’assistente, dà risposte o indizi, lascia tentare prima di intervenire? La terza: dove resta la relazione umana, in particolare nello sviluppo aperto come la leadership, dove oggi mancano prove a favore della sostituzione?
Gli studi citati sono per lo più piccoli, specifici e basati su strumenti già superati. Ma se il futuro è fatto di agenti che eseguono e di persone che controllano, la competenza di chi controlla è l’asset più delicato, ed è quello che le metriche attuali non vedono. È un’inferenza, non ancora dimostrata sul campo, ma abbastanza seria da meritare una misura. Una domanda per chi guida la formazione: cosa sa fare l’organizzazione quando l’assistente è spento?
Riferimenti bibliografici
Bastani H., Bastani O., Sungu A., Ge H., Kabakcı Ö., Mariman R., Generative AI Without Guardrails Can Harm Learning: Evidence from High School Mathematics, Pnas 122(26), 2025.
Shen J. H., Tamkin A., How AI Impacts Skill Formation, arXiv 2601.20245, 2026 (preprint).
Becker J., Rush N., Barnes E., Rein D. (Metr), Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, arXiv 2507.09089, 2025.
Lee H.-P., Sarkar A., Tankelevitch L., Drosos I., Rintel S., Banks R., Wilson N., The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers, conferenza Chi 2025.
de Haan E., Terblanche N., Nowack K., A Randomised Controlled Comparison of the Effectiveness of Human and AI Chatbot Coaching with Goal Attainment, Wellbeing and Self-Efficacy, Human Resource Development International, 2026.
Terblanche N., Molyn J., de Haan E., Nilsson V. O., Comparing Artificial Intelligence and Human Coaching Goal Attainment Efficacy, Plos One 17(6), 2022.
Soderstrom N. C., Bjork R. A., Learning Versus Performance: An Integrative Review, Perspectives on Psychological Science 10(2), 2015.
De Ascentiis M., Sap Now AI Tour, il Ritmo dell’Agentic AI Incalza, Inno3, 2026.
—
* Laureato in ingegneria elettronica/sistemi informativi al Politecnico, Pierpaolo Muzzolon trascorre tutta la vita in aziende hi-tech e IT nel marketing e nella comunicazione, oggi è counselor in analisi transazionale, coach e trainer.
© RIPRODUZIONE RISERVATA